Auf meiner Startseite gibt es einen Bereich „GitHub-Aktivität“. Dort sollen meine aktuellen Repositories erscheinen – mit Beschreibung, Sprache, Sternen und dem Datum des letzten Commits. Am Anfang habe ich diese Daten von Hand gepflegt. Das hat nicht lange funktioniert: Jedes neue Projekt und jede geänderte Beschreibung bedeutete wieder Arbeit, und nach ein paar Wochen war die Liste veraltet.
Die naheliegende Idee: Die Daten dort abholen, wo der Code ohnehin liegt – auf GitHub. In diesem Beitrag beschreibe ich, wie ich das in meinem ASP.NET-Core-Projekt umgesetzt habe und welche Stolperfallen mir dabei begegnet sind.
Die wichtigste Entscheidung: Wann frage ich GitHub ab?
Bevor ich eine Zeile Code geschrieben habe, musste ich überlegen, wann die Daten geholt werden. Ich habe drei Möglichkeiten verglichen:
- Im Browser per JavaScript: Jeder Besucher fragt GitHub selbst ab. Das ist einfach, aber jeder Browser verbindet sich dann mit GitHub (Datenschutz), und ohne Anmeldung erlaubt GitHub nur 60 Anfragen pro Stunde und IP-Adresse.
- Auf dem Server bei jedem Seitenaufruf: Besser für den Datenschutz, aber jede Anfrage an meine Startseite würde eine Anfrage an GitHub auslösen. Fällt GitHub aus, hat auch meine Seite ein Problem.
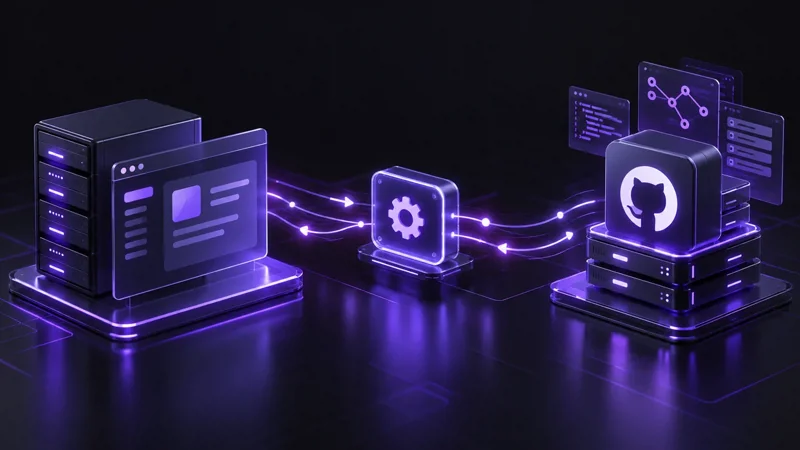
- Synchronisieren und in der eigenen Datenbank speichern: Ein Knopf im Admin-Bereich holt die Daten einmal ab und speichert sie. Die Startseite liest nur noch aus der Datenbank.
Ich habe mich für die dritte Variante entschieden. Besucher lösen nie eine Anfrage an GitHub aus, die Seite bleibt schnell, und sie funktioniert auch dann, wenn GitHub gerade nicht erreichbar ist. Außerdem kann ich im Admin-Bereich festlegen, welche Repositories auf der Startseite erscheinen und in welcher Reihenfolge – das wäre mit einer reinen Live-Abfrage nicht möglich.
Schritt 1: Einen HttpClient richtig einrichten
In ASP.NET Core sollte man HttpClient nicht einfach mit new erzeugen, sondern über die eingebaute Factory. Ich registriere meinen Dienst als sogenannten Typed Client:
// Program.cs
builder.Services.AddHttpClient<GitHubApiClientService>();
Im Konstruktor des Dienstes stelle ich alles ein, was GitHub erwartet:
public GitHubApiClientService(HttpClient httpClient, IConfiguration config)
{
    _httpClient = httpClient;
    _config = config;

    _httpClient.BaseAddress = new Uri("https://api.github.com/");
    // Ohne User-Agent antwortet GitHub mit 403 Forbidden
    _httpClient.DefaultRequestHeaders.UserAgent.Add(new ProductInfoHeaderValue("AmirRezaAfshar-Portfolio", "1.0"));
    _httpClient.DefaultRequestHeaders.Accept.Add(new MediaTypeWithQualityHeaderValue("application/vnd.github+json"));

    // Optionales Token: kommt aus der Konfiguration, nie aus dem Quellcode
    var token = _config["GitHub:Token"];
    if (!string.IsNullOrWhiteSpace(token))
        _httpClient.DefaultRequestHeaders.Authorization = new AuthenticationHeaderValue("Bearer", token);
}
Mit einem Token steigt das Limit von 60 auf 5.000 Anfragen pro Stunde. Für einen Sync per Knopfdruck würde auch das Limit ohne Token reichen – wichtig ist nur, dass das Token niemals im Code oder in Git landet. Bei mir liegt es lokal in den User Secrets und auf dem Server außerhalb des Codes in der Konfiguration.
Schritt 2: Die JSON-Antwort in eine C#-Klasse übersetzen
Die Liste der Repositories liefert der Endpunkt users/{benutzername}/repos. GitHub schreibt die Feldnamen in snake_case, also zum Beispiel html_url oder stargazers_count. Genau hier hatte ich meinen ersten Fehler: Meine Eigenschaften hießen HtmlUrl und StargazersCount – und blieben nach dem Einlesen einfach leer, ohne Fehlermeldung.
Die Lösung ist das Attribut [JsonPropertyName]:
private class GitHubApiRepoDto
{
    [JsonPropertyName("name")]             public string Name { get; set; } = string.Empty;
    [JsonPropertyName("description")]      public string? Description { get; set; }
    [JsonPropertyName("html_url")]         public string? HtmlUrl { get; set; }
    [JsonPropertyName("language")]         public string? Language { get; set; }
    [JsonPropertyName("stargazers_count")] public int StargazersCount { get; set; }
    [JsonPropertyName("pushed_at")]        public DateTime? PushedAt { get; set; }
    [JsonPropertyName("fork")]             public bool Fork { get; set; }
    [JsonPropertyName("archived")]         public bool Archived { get; set; }
}
Ein solches DTO (Data Transfer Object) enthält nur die Felder, die ich wirklich brauche. Den Rest der Antwort ignoriere ich.
Schritt 3: Synchronisieren statt nur Einlesen
Beim Sync gehe ich die Liste von GitHub durch und gleiche sie mit meiner Tabelle ab:
var response = await _httpClient.GetAsync($"users/{username}/repos?sort=pushed&per_page=100&type=owner");
if (!response.IsSuccessStatusCode)
    return (0, $"GitHub API hat einen Fehler zurückgegeben ({(int)response.StatusCode}).");

var repos = JsonSerializer.Deserialize<List<GitHubApiRepoDto>>(await response.Content.ReadAsStringAsync());

foreach (var dto in repos.Where(r => !r.Fork && !r.Archived))
{
    var existing = _gitHubRepoManager.FindByName(dto.Name);
    if (existing == null)
    {
        // neu: anlegen, aber noch nicht auf der Startseite zeigen
    }
    else
    {
        // vorhanden: nur die Felder von GitHub aktualisieren
    }
}
Zwei Regeln waren mir dabei wichtig:
- Geforkte und archivierte Repositories zeige ich nicht. Im Portfolio soll nur meine eigene, aktuelle Arbeit erscheinen.
- Meine eigene Auswahl bleibt erhalten. Ob ein Repository auf der Startseite erscheint und an welcher Stelle, entscheide ich im Admin-Bereich. Der Sync überschreibt nur die Daten, die von GitHub kommen.
Außerdem räumt der Sync auf: Repositories, die es auf GitHub nicht mehr gibt (gelöscht, archiviert oder umbenannt), werden aus meiner Tabelle entfernt. Damit das nur passiert, wenn die Antwort wirklich in Ordnung war, lösche ich nur dann etwas, wenn GitHub mindestens ein Repository geliefert hat.
Was ich gelernt habe
- Header gehören zur Schnittstelle. Ohne
User-Agentlehnt GitHub jede Anfrage ab. Solche Details stehen in der Dokumentation – man muss sie aber auch lesen. - Leere Felder sind oft ein Namensproblem. Wenn deserialisierte Werte leer bleiben, lohnt sich zuerst ein Blick auf die Feldnamen im JSON.
- Fehler als Meldung zurückgeben. Mein Sync gibt bei Problemen einen verständlichen Text zurück, den das Admin-Panel anzeigt, statt eine Ausnahme zu werfen. So sehe ich sofort, ob zum Beispiel das Limit erreicht ist.
- Geheimnisse gehören nicht in den Code. Token und Schlüssel kommen aus der Konfiguration.
- Grenzen kennen:
per_pageerlaubt höchstens 100 Einträge. Für mein Profil reicht das; bei mehr Repositories müsste ich mehrere Seiten abfragen.
Fazit
Für mich war dieses kleine Feature eine gute Übung, weil es viele Themen aus dem Alltag einer Anwendungsentwicklerin oder eines Anwendungsentwicklers verbindet: eine externe REST-Schnittstelle, asynchrone Programmierung mit async/await, JSON, eine eigene Datenbank und eine bewusste Architekturentscheidung. Und ganz praktisch: Meine Startseite zeigt jetzt immer die aktuellen Projekte, ohne dass ich etwas von Hand pflegen muss.
Kommentare.
Noch keine Kommentare vorhanden.